אתם מעלים שינוי קטן ב-CSS. שום דבר דרמטי. שבוע אחרי מישהו מציין שדף הבית מרגיש איטי, ועכשיו אתם חופרים בשישה commits כדי להבין איזה מהם הוסיף 400 מילישניות לזמן הטעינה. זאת בדיוק הבעיה ש-Lighthouse CI נועד לפתור.
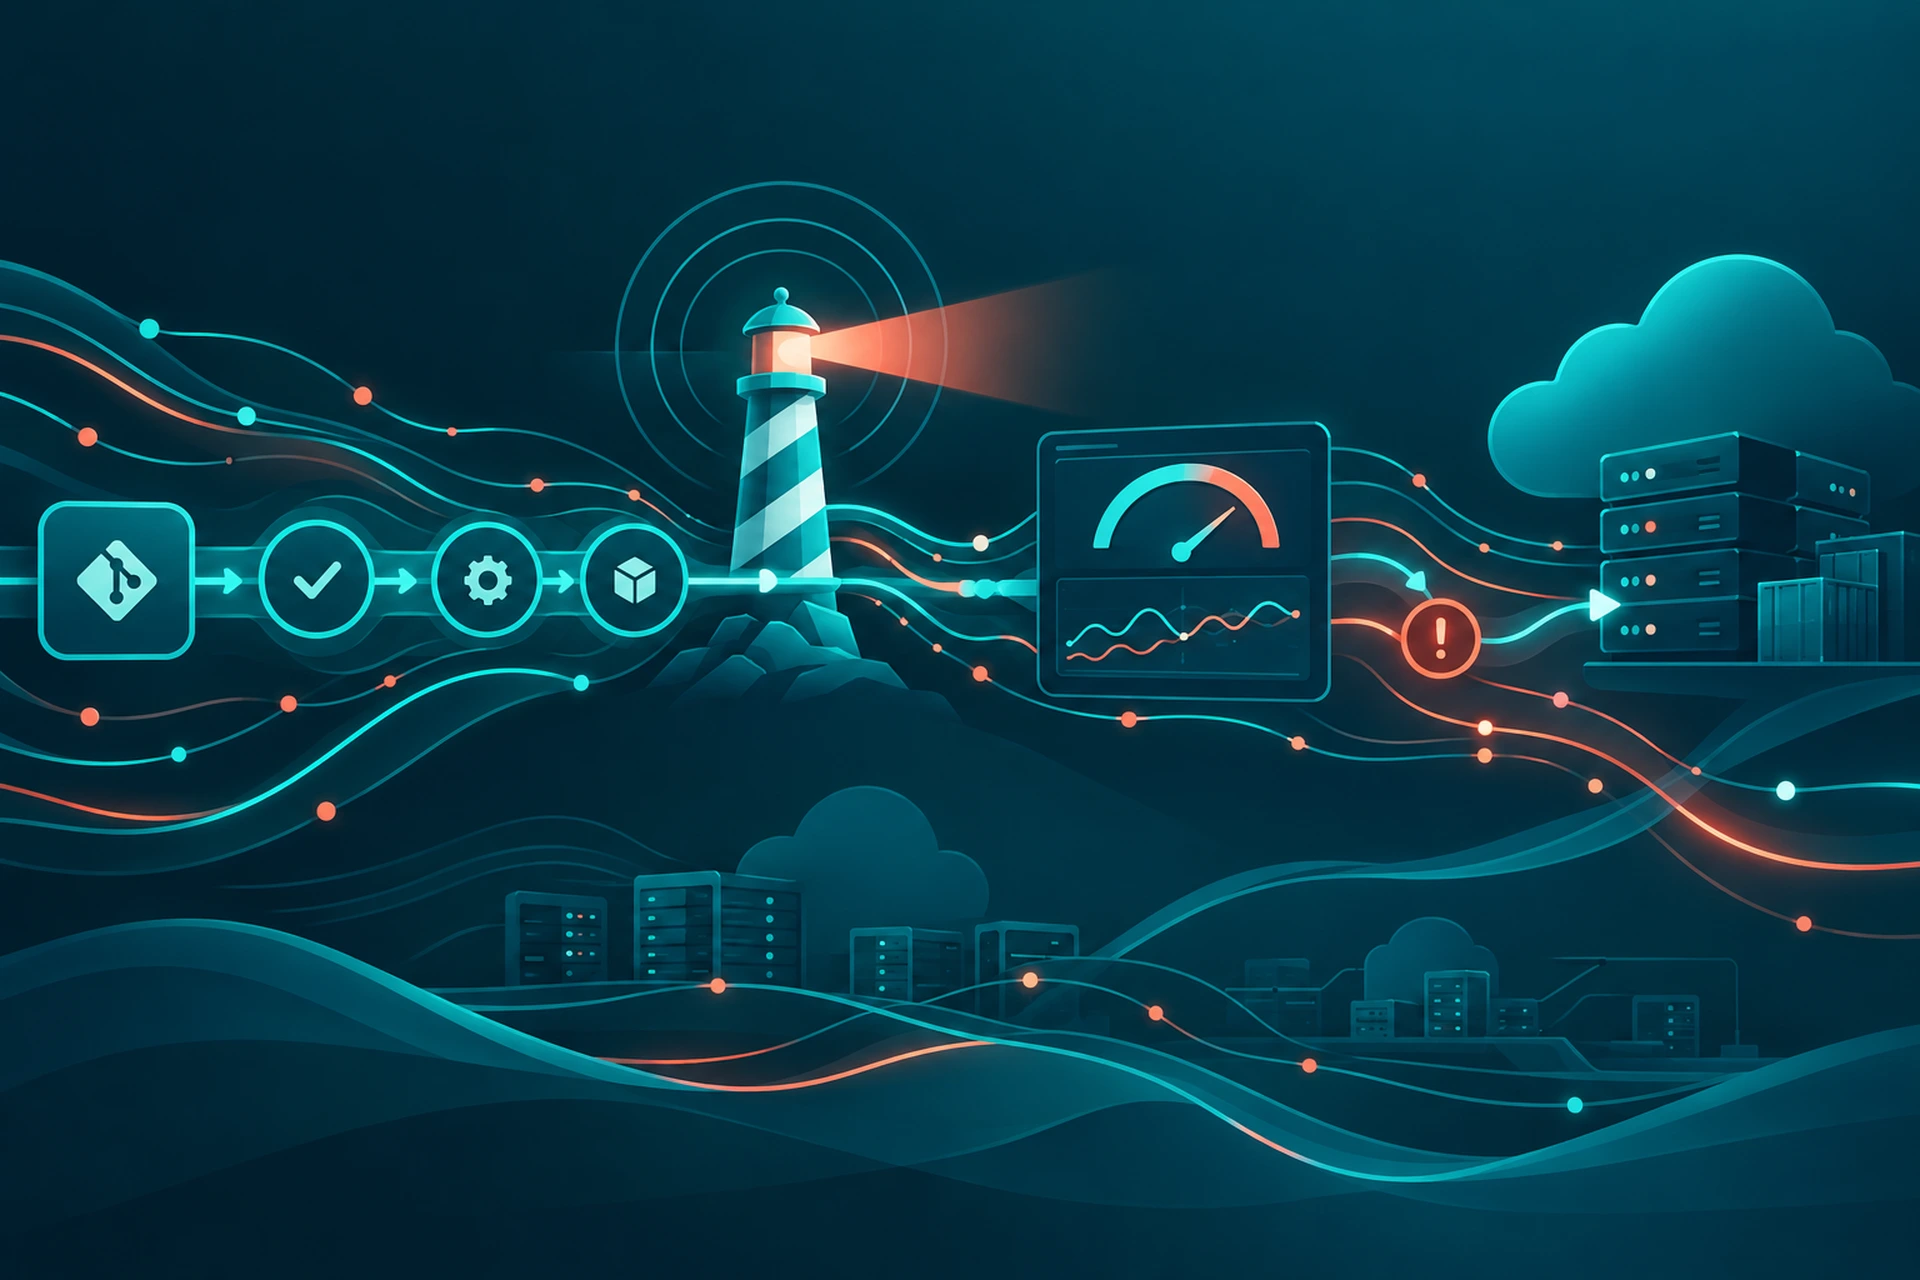
במקום לגלות על נסיגות בביצועים ממשתמש מתוסכל או מירידה בשיעור ההמרה, אתם תופסים אותן ברגע שהן נכנסות, ישירות בתוך צינור הפריסה שלכם.
מה Lighthouse CI באמת עושה
Lighthouse CI הוא הגרסה האוטומטית והניתנת לתכנות של בדיקות Lighthouse שכנראה הרצתם ידנית ב-Chrome DevTools. במקום ללחוץ על כפתור ולקרוא דוח פעם אחת, הוא מריץ את אותן בדיקות אוטומטית על כל pull request או פריסה, ואז משווה את התוצאות מול קו בסיס.
הוא מודד את המדדים שהכי חשובים לחוויית המשתמש האמיתית:
- Largest Contentful Paint (LCP) - כמה זמן לוקח עד שהתוכן המרכזי נראה
- Total Blocking Time (TBT) - כמה זמן ה-thread הראשי תפוס במהלך הטעינה
- Cumulative Layout Shift (CLS) - כמה הדף "קופץ" ממקום למקום תוך כדי טעינה
- Speed Index ו-Time to Interactive
אלו בדיוק המדדים שעומדים מאחורי Core Web Vitals, מה שאומר ש-Lighthouse CI נותן לכם קו ראייה ישיר לאיך הדירוג שלכם בגוגל וציוני חוויית המשתמש עלולים להשתנות, עוד לפני שהגעתם לסביבת הייצור.
איפה הוא משתלב בצינור שלכם
הערך האמיתי של Lighthouse CI מגיע מהמקום שבו אתם ממקמים אותו. הרצה ידנית פעם בחודש כמעט ולא אומרת לכם כלום שימושי. הרצה אוטומטית על כל build אומרת לכם בדיוק איזה commit גרם לבעיה.
על כל Pull Request
זה המקום הכי יעיל. כשמפתח פותח PR, Lighthouse CI מרים build, מריץ עליו בדיקות, ומוסיף תגובה עם התוצאות ישירות ל-PR. אם ה-LCP קופץ מ-1.8 שניות ל-3.2 שניות כי מישהו הוסיף תמונת hero לא ממוטבת, אתם רואים את זה לפני המיזוג, לא אחריו.
בסביבת Staging לפני הייצור
נקודת בדיקה שנייה בסביבת ה-staging תופסת בעיות שמופיעות רק עם נתונים או הגדרות שרת דומים לייצור. זה גם מקום טוב לבדוק תחת תנאים קרובים יותר לתעבורה אמיתית, מכיוון שסביבות staging מאפשרות לכם לבדוק שינויים בלי לגעת באתר החי שלכם.
אחרי הפריסה, כרשת ביטחון
גם עם בדיקות מוקדמות יותר בצינור, חכם להריץ Lighthouse CI מול הייצור מדי פעם אחרי פריסות. גורמים מהעולם האמיתי כמו חימום מטמון ה-CDN או שינויים בסקריפטים של צד שלישי יכולים לשנות ציונים בדרכים שה-staging לא תמיד חושף.
הגדרת תקציבי ביצועים שבאמת חוסמים פריסות גרועות
Lighthouse CI הופך לשימושי באמת ברגע שמגדירים תקציבי ביצועים, סף ספציפי שגורם ל-build להיכשל אם חוצים אותו. בלי תקציבים, אתם רק מייצרים דוחות שאף אחד לא קורא.
תצורת תקציב בסיסית נראית כך:
{ "ci": { "assert": { "assertions": { "largest-contentful-paint": ["error", {"maxNumericValue": 2500}], "total-blocking-time": ["error", {"maxNumericValue": 300}], "cumulative-layout-shift": ["error", {"maxNumericValue": 0.1}] } } } }עם זה במקום, pull request שדוחף את ה-LCP מעל 2.5 שניות פשוט לא יכול להתמזג עד שמישהו מתקן את זה. זה ההבדל בין ביצועים שהם המלצה לבין ביצועים שהם דרישה.
מכשולים נפוצים שגורמים ל-Lighthouse CI להיות "רועש"
צוותים רבים נוטשים את Lighthouse CI תוך חודש כי התוצאות מרגישות לא עקביות. כמה תיקונים פותרים את רוב הבעיה:
- הריצו כמה ניסיונות לכל בדיקה. הרצה בודדת יכולה להשתנות ב-15-20% בגלל רעשי מערכת רגילים. ממוצע של 3-5 הרצות מחליק את זה.
- השתמשו בהאטת חומרה עקבית. Lighthouse מדמה כברירת מחדל מכשיר נייד בדרגה בינונית. שמרו על עקביות בין ההרצות כדי שתשוו תפוחים לתפוחים.
- הפרידו בין בדיקות טעינה ראשונה לטעינה ממטמון. דף שנראה מהיר בביקור חוזר אולי מסתיר ציור ראשון איטי.
- אל תבדקו מול שרת "קר". אם סביבת הבדיקה שלכם צריכה לעלות מאפס, מספרי Time to First Byte שלכם יהיו מטעים. זו אחת הסיבות לכך שזמן תגובת השרת כל כך חשוב, נושא שכיסינו במאמר למה זמן ה-Time to First Byte עולה לכם בהמרות ואיך לתקן את זה.
למה זה חשוב מעבר ללוח המחוונים
נסיגות בביצועים לרוב אינן דרמטיות. בדרך כלל זה זחילה של 200 מילישניות כאן, תמונה של 50KB שם, סקריפט מעקב נוסף שהוכנס בלי מחשבה שנייה. אף אחד מאלה לא מרגיש דחוף בפני עצמו. אחרי חצי שנה, כל אלה מצטברים לאתר שאיטי משמעותית ממה שהיה, בלי שום commit בודד להאשים.
Lighthouse CI הופך את הזחילה האיטית הזאת לדבר נראה וניתן לייחוס. כל נסיגה מקושרת לשינוי ספציפי, מה שהופך את התיקון לאחריות של מישהו לפני השחרור, במקום משהו לטפל בו מאוחר יותר כשהתנועה כבר ירדה.
זה משתלב היטב גם עם בדיקות סינתטיות מתמשכות אחרי הפריסה. כתבנו עוד על הגישה הזו במאמר איך ניטור סינתטי תופס נסיגות בביצועים לפני שהן מגיעות לייצור, שמכסה את החצי השני של המשוואה, בצד הייצור.
איך מתחילים בלי לשנות את כל הצינור
אתם לא צריכים לבנות מחדש את כל ה-CI/CD כדי להתחיל להשתמש ב-Lighthouse CI. רוב הצוותים מתחילים בהגדרה קלה:
- הוסיפו את החבילה @lhci/cli למאגר שלכם
- הגדירו GitHub Action או GitLab CI job שירוץ על pull requests
- התחילו עם אזהרות במקום כשלים קשיחים בשבועות הראשונים
- ברגע שקו הבסיס שלכם מתייצב, הפכו מדדים מרכזיים ל-assertions חוסמים
אם סביבת האחסון שלכם סובלת מזמני תגובה לא עקביים, תוצאות Lighthouse CI ינדנדו בכל מקרה, לא משנה כמה בקפידה תגדירו אותו. זו פחות בעיה של כלים ויותר בעיה של תשתית. למבט מעמיק יותר על הגורמים בצד השרת שמעצבים את קו הבסיס שלכם, ראו איך באמת נראית אחסון אתרים מהיר מתחת למכסה המנוע.
לסיכום
ניטור ביצועי אתר לא צריך להתחיל אחרי ההשקה, הוא צריך להתחיל ב-pull requests שלכם. Lighthouse CI נותן לכם דרך חוזרת ואוטומטית למדוד את המדדים שבאמת משפיעים על המשתמשים שלכם ועל דירוג החיפוש שלכם, והוא תופס נסיגות בעודן שינוי של שורה אחת במקום תעלומה שלושה שבועות אחר כך. הגדירו תקציב, חברו אותו לצינור שלכם, ותנו לו לעשות את העבודה המשעממת של לעקוב אחרי כל פריסה בודדת כדי שלא תצטרכו.