אם האפליקציה שלך מתנהגת באיטיות תחת עומס, גם כשהשאילתות שלך נראות תקינות על הנייר, הבעיה אולי לא בשאילתות בכלל. היא יכולה להיות בדרך שבה האפליקציה שלך מתחברת לבסיס הנתונים כבר מההתחלה. לכל חיבור חדש יש עלות, ואם אתה משלם אותה בכל בקשה ובקשה, אתה משאיר על השולחן הרבה ביצועים.
כאן נכנס לתמונה connection pooling. זה אחד מאותם מושגי backend לא זוהרים שבשקט עושים הבדל אדיר, ברגע שמבינים אותם.
מה עולה לך חיבור לבסיס נתונים בפועל
פתיחת חיבור חדש לבסיס נתונים אינה חינמית. במערכות כמו MySQL או PostgreSQL, חיבור טרי כולל תהליך TCP handshake, אימות, הקמת session, ולעיתים גם משא ומתן על SSL. תלוי בהגדרות שלך, זה יכול לקחת בין כמה מילישניות ל-50ms או יותר.
עכשיו הכפל את זה בכל בקשה שהאפליקציה שלך מטפלת בה. אם אתה מריץ אפליקציית PHP שפותחת וסוגרת חיבור בכל טעינת עמוד, ואתה מקבל 100 בקשות בשנייה, אתה שורף חלק ניכר מזמן התגובה הכולל רק על הקמת חיבור, לפני שאפילו שאילתה אחת רצה.
כיסינו נושא קשור במאמר מדוע שאילתות איטיות הן צוואר הבקבוק הנסתר ברוב אפליקציות הווב, אבל עומס החיבורים הוא בעיה נפרדת בפני עצמה. השאילתות שלך יכולות להיות מאונדקסות ומשופרות ביסודיות, ואתה עדיין תחוש את המחיר הזה בכל בקשה.
איך connection pooling פותר את זה
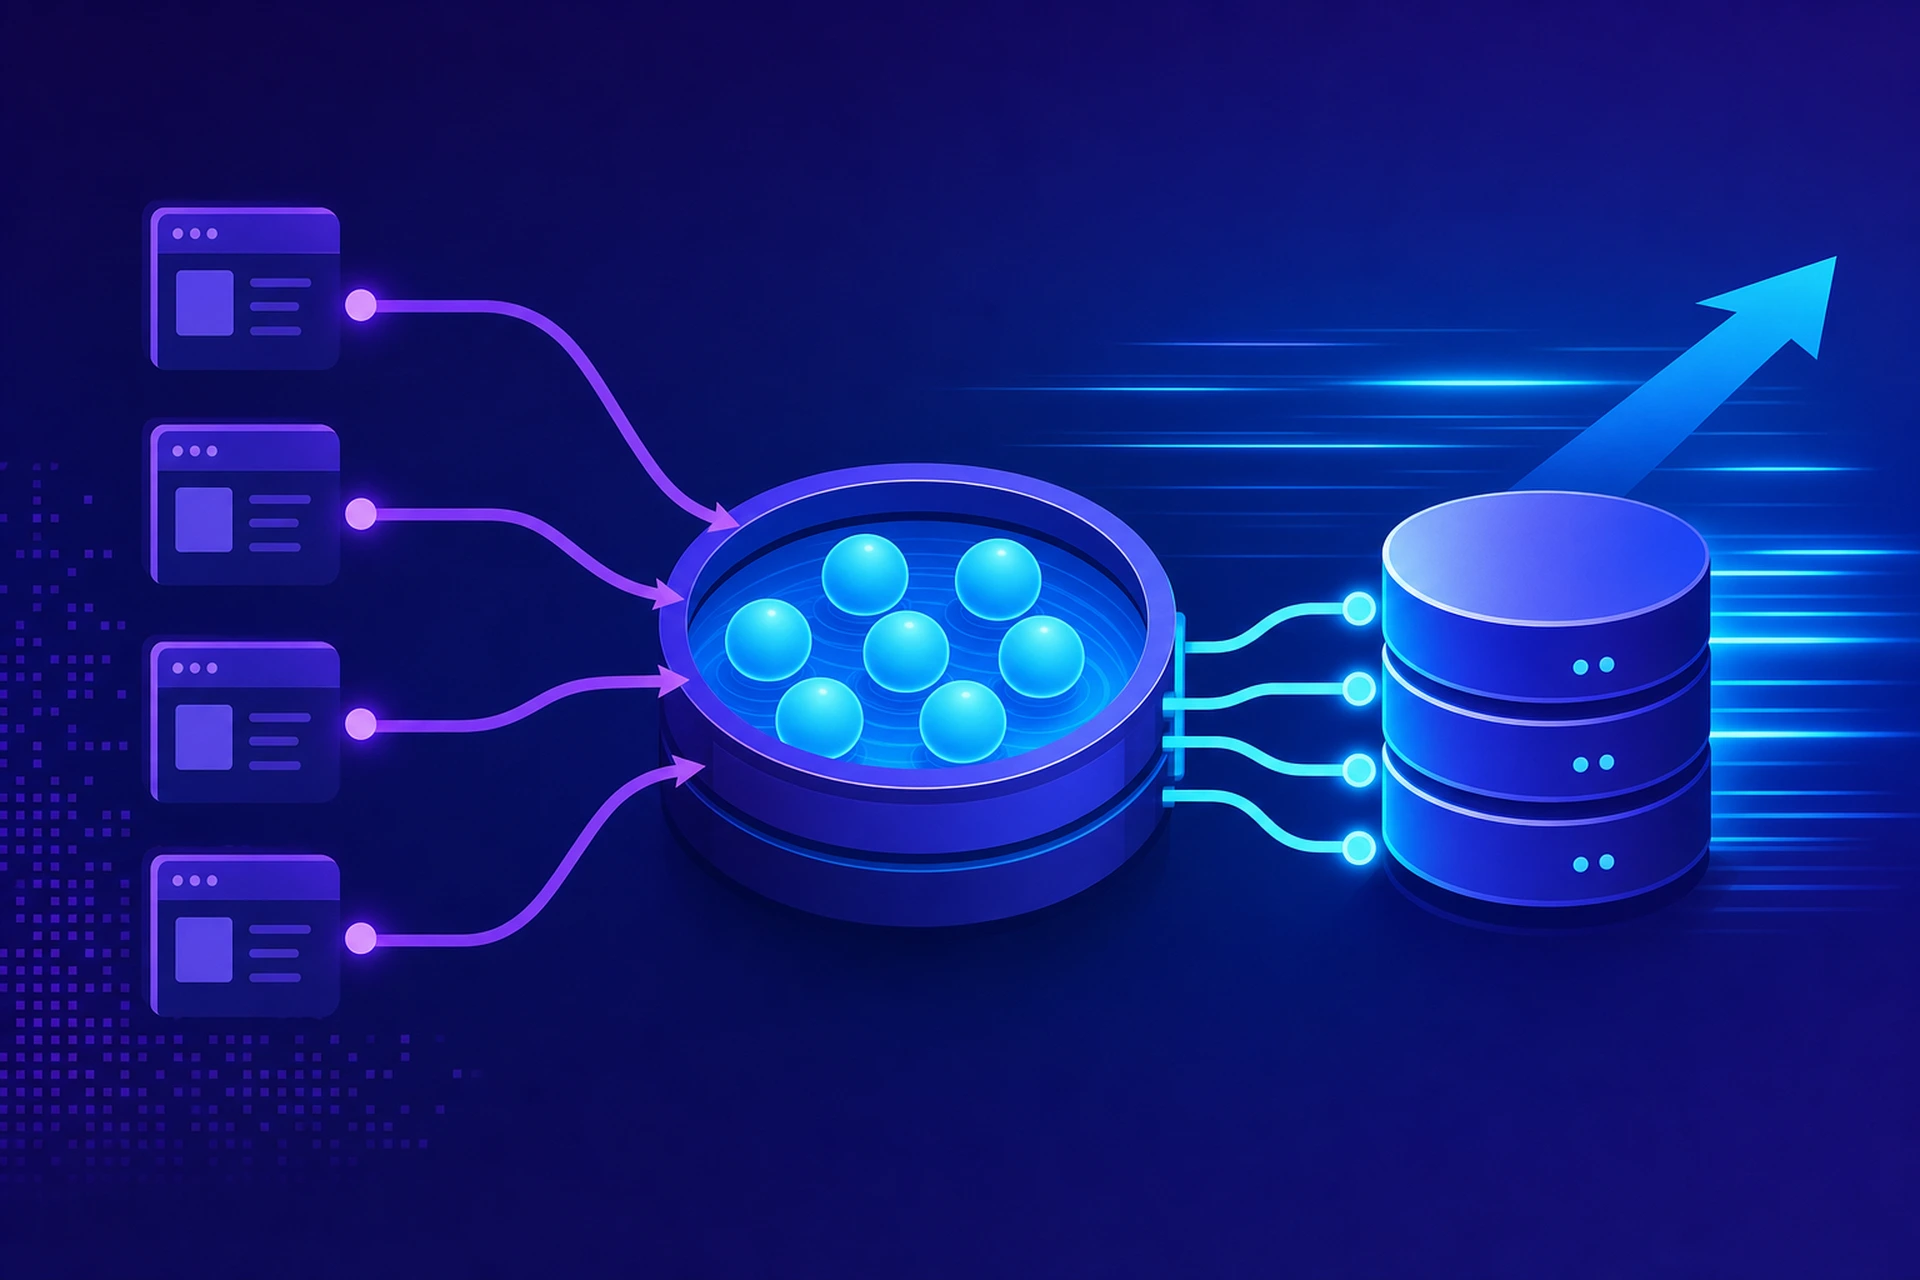
Connection pooling שומר קבוצה של חיבורים פתוחים מראש, מוכנים לפעולה. במקום לפתוח חיבור חדש לכל בקשה, האפליקציה שלך "שואלת" חיבור מהמאגר (pool), משתמשת בו, ומחזירה אותו כשהיא מסיימת. אין handshake, אין אימות חדש, אין מילישניות מבוזבזות.
תחשוב על זה כמו תחנת מוניות במקום להזמין שירות רכב חדש בכל פעם שאתה צריך טרמפ. המוניות כבר שם, המנועים פועלים, מוכנות לצאת לדרך.
דוגמה פשוטה
בלי pooling, אפליקציית Node.js שמשתמשת ב-mysql2 driver עלולה להיראות כך בכל בקשה:
const connection = await mysql.createConnection(config);
const [rows] = await connection.query('SELECT * FROM users WHERE id = ?', [id]);
await connection.end();
עם pooling, אתה יוצר את המאגר פעם אחת, בעת הפעלת האפליקציה:
const pool = mysql.createPool({ host: 'localhost', user: 'app', database: 'mydb', connectionLimit: 20 });
ואז כל בקשה פשוט שואלת ממנו:
const [rows] = await pool.query('SELECT * FROM users WHERE id = ?', [id]);
עלות הקמת החיבור מתרחשת רק 20 פעמים, פעם אחת לכל חיבור במאגר, לא משנה כמה אלפי בקשות יגיעו אחר כך.
מספרים אמיתיים: מה pooling חוסך בפועל
החיסכון המדויק תלוי בבסיס הנתונים שלך, בזמן ההשתלחות ברשת, ובעומס העבודה, אבל הנה תמונה מציאותית מבנצ'מרקים נפוצים:
- הקמת חיבור בלי pooling: 5ms עד 50ms לבקשה
- הקמת חיבור עם pooling: מתחת ל-1ms (רק לקיחת חיבור פנוי)
- בעומס גבוה (500+ בקשות בשנייה), חיבורים בלי pooling יכולים לחסל לחלוטין את מגבלת max_connections של בסיס הנתונים שלך, מה שיוצר שגיאות ולא רק איטיות
- מאגרים מכוונים היטב מקצרים בממוצע את זמן התגובה ב-20-40% בנקודות קצה עם עומס בסיס נתונים כבד
הנקודה האחרונה על max_connections היא לרוב המצב החירום האמיתי. PostgreSQL כברירת מחדל מוגבל ל-100 חיבורים מקסימליים. MySQL מוגבל כברירת מחדל ל-151. אם האפליקציה שלך פותחת חיבור גולמי לכל בקשה והתעבורה קופצת, אתה תגיע לתקרה הזו מהר, וכל בקשה אחרי זה תיכשל לחלוטין.
בחירת גודל המאגר הנכון
מאגר גדול יותר לא בהכרח טוב יותר. כל חיבור פתוח צורך זיכרון בשרת בסיס הנתונים, ויותר מדי חיבורים במצב סרק יכולים בעצם לפגוע בביצועים כי נגרם עומס ותחרות על משאבים.
נוסחת התחלה נפוצה, שהופצה על ידי כלים כמו PgBouncer, היא:
pool_size = ((core_count * 2) + effective_spindle_count)
בפועל, לרוב אפליקציות קטנות עד בגודל בינוני, מאגר של 10 עד 30 חיבורים לכל שרת אפליקציה עובד מצוין. אם אתה מריץ כמה שרתי אפליקציה, זכור שלכל אחד יש מאגר משלו, כך שמספר החיבורים הכולל שמגיע לבסיס הנתונים הוא גודל המאגר כפול מספר השרתים.
Pooling ברמת האפליקציה מול Poolers חיצוניים
יש לך שתי אפשרויות מרכזיות:
- Pooling ברמת האפליקציה: מובנה ב-driver של בסיס הנתונים שלך (mysql2, node-postgres, HikariCP ל-Java). קל להגדיר, אבל כל instance של האפליקציה מנהל מאגר משלו בנפרד.
- Pooler חיצוני: כלים כמו PgBouncer ל-PostgreSQL או ProxySQL ל-MySQL נמצאים בין האפליקציה שלך לבסיס הנתונים, ומנהלים מאגר משותף בין כמה instances של האפליקציה. זו הבחירה הטובה יותר ברגע שאתה מריץ יותר משרת אפליקציה אחד או שניים.
PgBouncer בפרט שווה להכיר אם אתה עובד עם PostgreSQL. הוא תומך ב-pooling בגובה של transaction, שבו חיבור נשמר רק למשך transaction בודד ולא לכל ה-session של הלקוח, מה שמאפשר לך לשרת הרבה יותר לקוחות ממגבלת max_connections האמיתית שלך.
איפה pooling משתלב עם caching
Connection pooling מפחית את העומס לכל בקשה, אבל הוא לא מפחית את כמות השאילתות שאתה מריץ. אם אתה פוגע בבסיס הנתונים עם אותן שאילתות קריאה שוב ושוב, שילוב של pooling עם שכבת caching כמו Redis נותן לך את הטוב משני העולמות: פחות חיבורים מבוזבזים על הקמה, ופחות שאילתות שמגיעות לבסיס הנתונים בכלל. כתבנו יותר על השילוב הזה במאמר Memcached מול Redis: איזו שכבת caching מתאימה לשרת שלך.
אם אתה מריץ WordPress בפרט, חלק גדול מהעומס הזה של החיבורים נטפל עבורך כשה-object caching מוגדר נכון, כי זה מקצץ בסיבובי הליכה חזור-ושוב מיותרים לבסיס הנתונים עוד לפני שה-pooling נכנס לתמונה.
איך לבצע נכון אופטימיזציית בסיס נתונים באירוח
זה בעצם הליבה של אופטימיזציית בסיס נתונים טובה באירוח: זה לא רק דיסקים מהירים ומספיק RAM, זה עד כמה כל המערך יעיל בטיפול בחיבורים, שאילתות, ו-caching בבת אחת. שרת עם חומרה מצוינת אבל מאגר חיבורים לא מוגדר נכון עדיין ייתקע תחת עומס, ומאגר מכוון היטב על חומרה חלשה רק ייקח אותך עד לנקודה מוגבלת.
כשאנחנו מגדירים סביבות VPS לקוחות, כיוונון מגבלות החיבורים וגדלי המאגרים כדי להתאים לעומס העבודה בפועל הוא חלק ממה שהופך אופטימיזציית בסיס נתונים באירוח באמת ליישום ולא רק לביטוי שיווקי. אם אתה מנהל את זה בעצמך, בדוק את מספר החיבורים הנוכחי בבסיס הנתונים שלך תחת עומס עם שאילתה פשוטה כמו SHOW STATUS LIKE 'Threads_connected'; ב-MySQL, והשווה את זה להגדרת max_connections שלך. אם אתה קרוב באופן קבוע לתקרה, זה הסימן שה-pooling צריך תשומת לב עכשיו, לא אחרי ההשבתה הבאה.
לסיכום
Connection pooling הוא אחד השינויים בעלי ההשפעה הגבוהה ביותר שאתה יכול לעשות באפליקציה שמבוססת על בסיס נתונים. זה לא זוהר, וזה לא יופיע בצילום מסך של עמוד בית מהיר, אבל זה לרוב ההבדל בין אפליקציה שמתדרדרת בעדינות תחת עומס לבין אחת שקורסת לחלוטין. בדוק את הגדרת המאגר הנוכחית שלך היום. אם אין לך אחת, זה כנראה השיפור הביצועים האמיתי הבא שלך.