تقوم بنشر تعديل بسيط في CSS. لا شيء درامي. وبعد أسبوع، يخبرك أحدهم أن الصفحة الرئيسية تبدو بطيئة، وتجد نفسك تبحث في ست عمليات commit لمعرفة أيها أضاف 400 مللي ثانية إلى زمن التحميل. هذه بالضبط المشكلة التي صُمم Lighthouse CI لحلها.
بدلًا من اكتشاف تراجع الأداء من خلال مستخدم محبط أو انخفاض في معدل التحويل، يمكنك رصد المشكلة لحظة ظهورها، مباشرة ضمن خط النشر الخاص بك.
ما الذي يفعله Lighthouse CI فعليًا
Lighthouse CI هو النسخة الآلية والقابلة للبرمجة من اختبارات Lighthouse التي ربما شغّلتها يدويًا في Chrome DevTools من قبل. فبدلًا من الضغط على زر وقراءة تقرير مرة واحدة، يقوم بتشغيل نفس الاختبارات تلقائيًا على كل pull request أو عملية نشر، ثم يقارن النتائج بخط أساسي محدد مسبقًا.
يقيس Lighthouse CI أهم المقاييس التي تؤثر على تجربة المستخدم الحقيقية:
- Largest Contentful Paint (LCP) - المدة حتى يظهر المحتوى الرئيسي
- Total Blocking Time (TBT) - مدة انشغال المسار الرئيسي أثناء التحميل
- Cumulative Layout Shift (CLS) - مقدار اهتزاز العناصر أثناء التحميل
- Speed Index و Time to Interactive
هذه هي نفس المقاييس التي تعتمد عليها Core Web Vitals، ما يعني أن Lighthouse CI يمنحك رؤية مباشرة لكيفية تأثر ترتيبك في محركات البحث ومؤشرات تجربة المستخدم قبل أن تصل التغييرات إلى الإنتاج الفعلي. وهذا جزء أساسي من مراقبة أداء الموقع بشكل استباقي بدلًا من ردة الفعل المتأخرة.
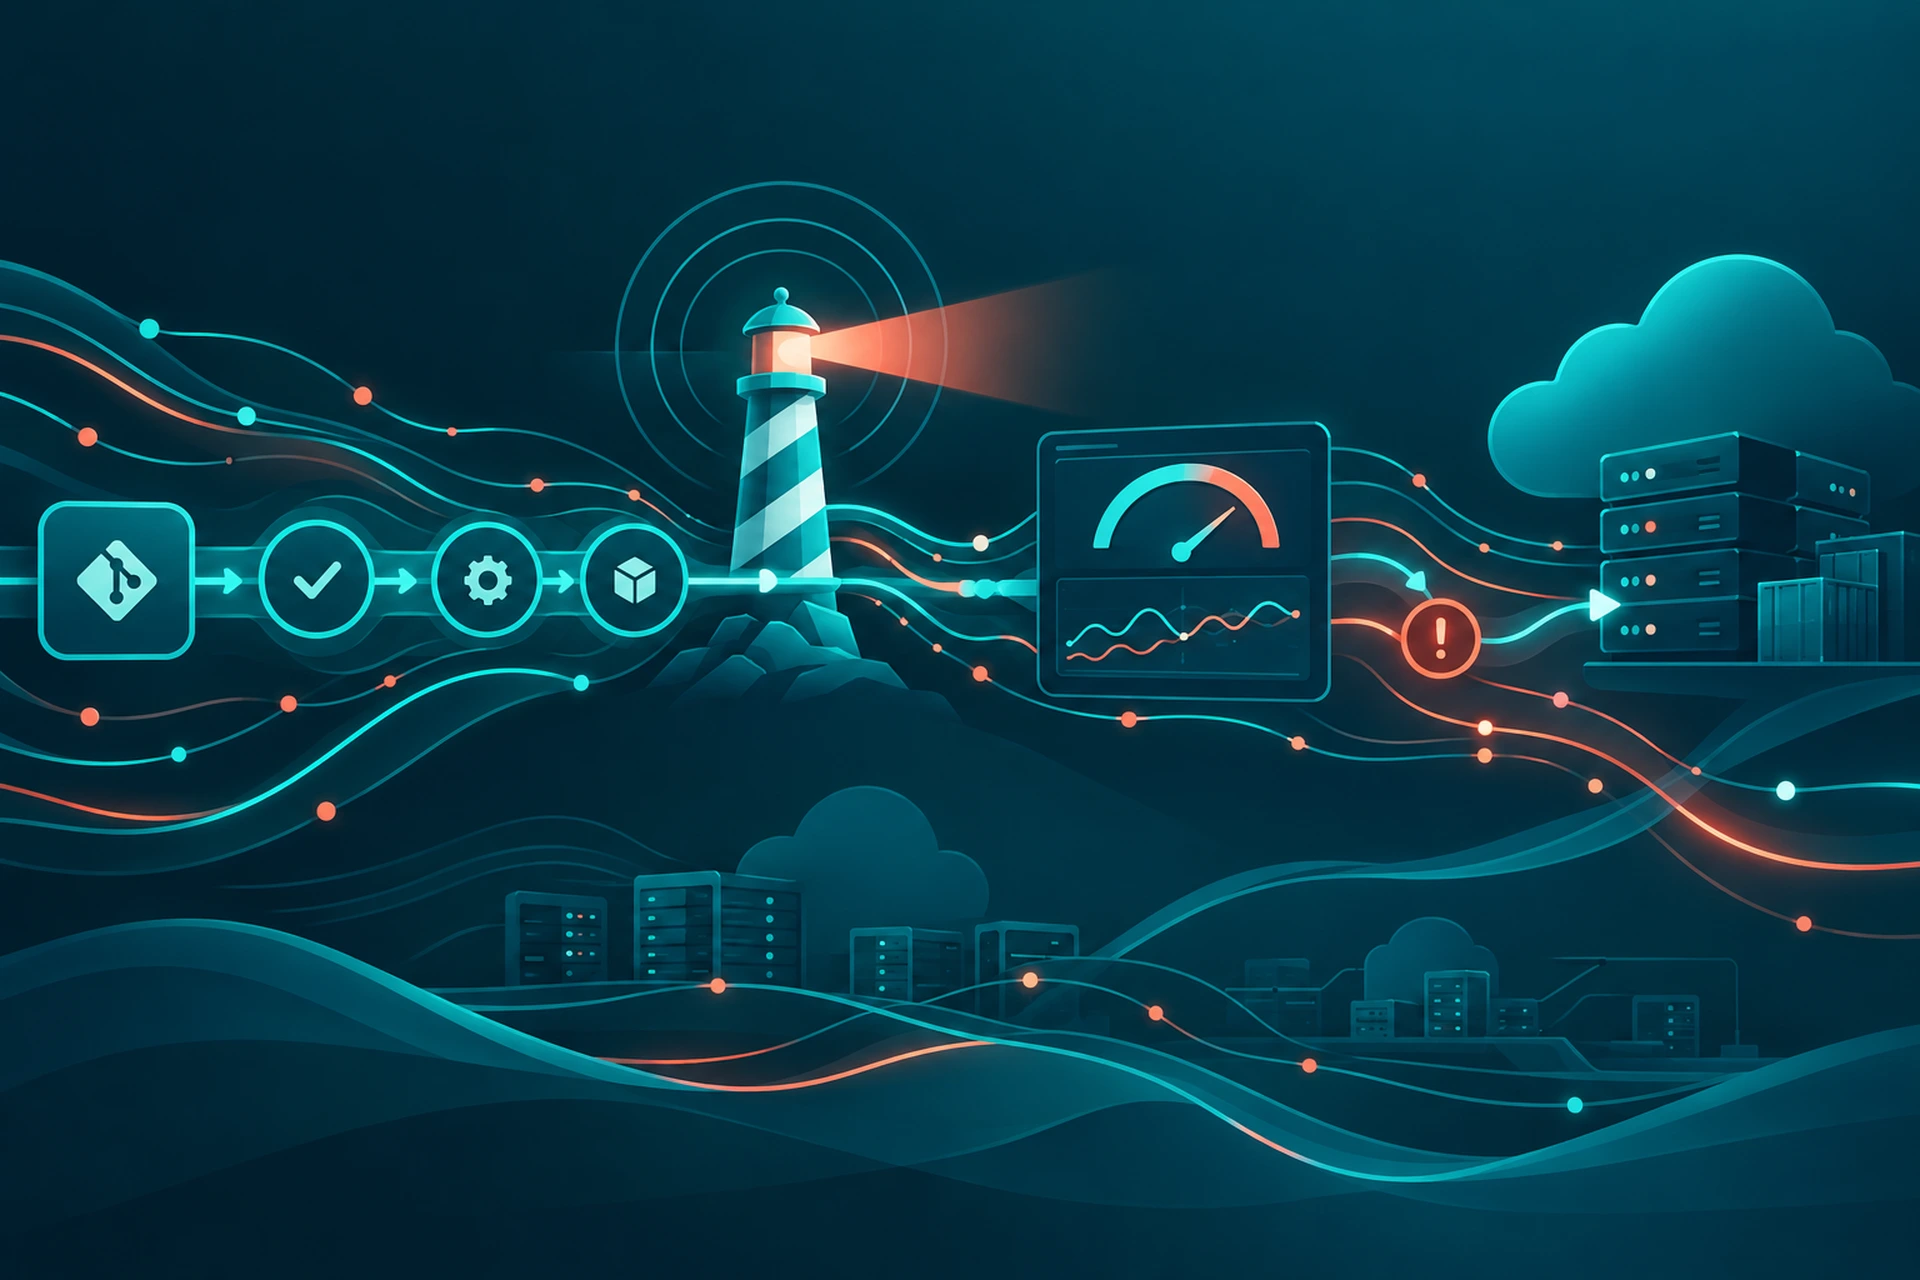
أين يندمج ضمن خط النشر لديك
القيمة الحقيقية لـ Lighthouse CI تأتي من موضعه في خط النشر. تشغيله يدويًا مرة واحدة شهريًا لا يخبرك بالكثير. أما تشغيله تلقائيًا على كل بناء، فيخبرك بالضبط أي commit تسبب في المشكلة.
على كل Pull Request
هذه هي النقطة الأكثر فاعلية. عندما يفتح أحد المطورين pull request، يقوم Lighthouse CI ببناء نسخة وتشغيل الاختبارات عليها، ثم يضيف النتائج مباشرة كتعليق على الـ PR. فإذا قفز LCP من 1.8 ثانية إلى 3.2 ثانية بسبب صورة رئيسية غير محسّنة، ستراها قبل الدمج، لا بعده.
على بيئة Staging قبل الإنتاج
نقطة تحقق ثانية على بيئة staging تكشف مشكلات لا تظهر إلا مع بيانات أو إعدادات خوادم مشابهة للإنتاج الفعلي. هذا أيضًا مكان جيد لاختبار الأداء في ظروف أقرب للحركة الحقيقية، لأن بيئات staging تتيح لك التحقق من التغييرات دون المساس بموقعك المباشر.
بعد النشر كشبكة أمان
حتى مع وجود فحوصات مبكرة في خط النشر، من الذكي تشغيل Lighthouse CI دوريًا على بيئة الإنتاج بعد عمليات النشر. عوامل واقعية مثل إحماء ذاكرة التخزين المؤقت لـ CDN أو تغييرات في سكربتات طرف ثالث قد تؤثر على النتائج بطرق لا تظهر دائمًا في staging.
وضع ميزانيات أداء تمنع فعليًا عمليات النشر السيئة
يصبح Lighthouse CI مفيدًا حقًا عندما تحدد ميزانيات أداء، أي حدود معينة تُفشل عملية البناء إذا تم تجاوزها. فبدون هذه الميزانيات، أنت فقط تنتج تقارير لا يقرأها أحد.
تبدو إعدادات الميزانية الأساسية هكذا:
{ "ci": { "assert": { "assertions": { "largest-contentful-paint": ["error", {"maxNumericValue": 2500}], "total-blocking-time": ["error", {"maxNumericValue": 300}], "cumulative-layout-shift": ["error", {"maxNumericValue": 0.1}] } } } }مع هذا الإعداد، لا يمكن دمج pull request يرفع LCP فوق 2.5 ثانية حتى يقوم أحد بإصلاح المشكلة. هذا هو الفرق بين أن يكون الأداء مجرد اقتراح وبين أن يكون شرطًا أساسيًا.
مشكلات شائعة تجعل نتائج Lighthouse CI غير مستقرة
كثير من الفرق تتخلى عن Lighthouse CI خلال شهر لأن النتائج تبدو غير متسقة. بعض الإصلاحات البسيطة تحل معظم هذه المشكلة:
- شغّل عدة محاولات لكل اختبار. يمكن أن تتفاوت نتيجة التشغيل الواحد بنسبة 15-20% بسبب تذبذبات النظام الطبيعية. حساب متوسط 3-5 تشغيلات يقلل هذا التفاوت.
- استخدم إعدادات تقييد أجهزة ثابتة. يحاكي Lighthouse افتراضيًا جهازًا محمولًا متوسط الأداء. حافظ على ثبات هذا الإعداد عبر كل التشغيلات حتى تكون المقارنة عادلة.
- افصل بين اختبارات التحميل الأول والتحميل المخزن مؤقتًا. الصفحة التي تبدو سريعة عند الزيارات المتكررة قد تخفي بطئًا في أول عرض.
- لا تختبر على خادم بارد. إذا كانت بيئة الاختبار تحتاج للبدء من الصفر، فستكون أرقام Time to First Byte مضللة. هذا أحد الأسباب التي تجعل زمن استجابة الخادم مهمًا جدًا، وهو أمر تناولناه في لماذا يكلفك زمن Time to First Byte تحويلات ضائعة وكيف تصلح ذلك.
لماذا يهم هذا الأمر أبعد من لوحة التحكم
تراجع الأداء نادرًا ما يكون دراميًا. عادة ما يكون زيادة 200 مللي ثانية هنا، صورة إضافية بحجم 50 كيلوبايت هناك، سكربت تتبع إضافي أُضيف دون تفكير. لا شيء من هذا يبدو عاجلًا بمفرده. لكن خلال ستة أشهر، تتراكم هذه التغييرات لتصبح الموقع أبطأ بشكل ملحوظ، دون وجود commit واحد واضح يمكن تحميله المسؤولية.
يحوّل Lighthouse CI هذا التباطؤ التدريجي إلى شيء مرئي وقابل للتتبع. كل تراجع في الأداء يُربط بتغيير محدد، مما يجعل إصلاحه مسؤولية واضحة قبل النشر، لا مشكلة يتم تصنيفها لاحقًا بعد أن تكون حركة المرور قد انخفضت بالفعل.
هذا النهج يتكامل جيدًا مع فحوصات اصطناعية مستمرة بعد النشر أيضًا. كتبنا بتفصيل أكثر عن هذا النهج في كيف يكشف Synthetic Monitoring تراجع الأداء قبل وصوله إلى الإنتاج، والذي يغطي الجانب الخاص بمراقبة الإنتاج من هذه المعادلة.
البدء دون الحاجة لإعادة بناء خط النشر بالكامل
لا تحتاج إلى إعادة بناء كاملة لـ CI/CD لتبدأ باستخدام Lighthouse CI. تبدأ معظم الفرق بإعداد بسيط:
- أضف حزمة @lhci/cli إلى مستودعك
- أعدّ GitHub Action أو مهمة GitLab CI لتشغيله على الـ pull requests
- ابدأ بتحذيرات بدلًا من إخفاقات قاطعة للأسابيع الأولى
- بمجرد استقرار خط الأساس لديك، حوّل المقاييس الأساسية إلى شروط حاسمة تمنع الدمج
إذا كانت بيئة الاستضافة الأساسية لديك تعاني من أزمنة استجابة غير متسقة، فستتذبذب نتائج Lighthouse CI مهما دققت في الإعدادات. هذه ليست مشكلة أدوات بقدر ما هي مشكلة بنية تحتية. للاطلاع على عوامل جانب الخادم التي تشكّل خط الأساس لديك بعمق أكبر، راجع كيف تبدو الاستضافة السريعة فعليًا من الداخل.
الخلاصة
لا ينبغي أن تبدأ مراقبة أداء الموقع بعد الإطلاق، بل يجب أن تبدأ في الـ pull requests. يمنحك Lighthouse CI طريقة آلية وقابلة للتكرار لقياس المقاييس التي تؤثر فعلًا على مستخدميك وعلى ترتيبك في نتائج البحث، ويكشف تراجع الأداء وهو لا يزال تغييرًا بسيطًا بسطر واحد بدلًا من لغز يُكتشف بعد ثلاثة أسابيع. ضع ميزانية أداء، اربطها بخط النشر لديك، ودعها تقوم بالعمل الممل المتمثل في مراقبة كل عملية نشر حتى لا تضطر أنت لذلك.